0. はじめに
こんにちは。クラウドセントリック株式会社の 中山 です。
普段は主にAIエージェント開発案件を担当しています。
今回は、GitHub Nextが2026年9月18日に公開したLocalJevを動かしてみました。
1. Jevって何?
LocalJevの話をする前に、まずはJevについて簡単にご説明します。
Jevは、TypeSafe.aiが2026年9月15日に早期アクセスとして公開した、ソフトウェア内での意思決定に特化したAIモデルで(TypeSafe.aiは「System One Model」と呼んでいます)、同社のAPI(POST /v1/systemone)から利用します。
一般的なLLMのChat Completions APIが「自由文で質問し、自由文で回答を得る」チャット形式なのに対し、JevのAPIは判断材料と「型付き」の質問群を渡すと、構造化された回答を返すという設計になっています。
1-1. 型付きとは
Jevのリクエストは、使用するモデル名(model)のほか、大きく2つの要素で構成されます。
- state:判断材料となる文脈(例:飲食店に投稿された口コミ本文)
- questions:構造化された質問セット。各質問にはtypeがあり、次の3種類があります。
- choice:複数の選択肢から1つを選ぶ(例:口コミで主に語られている観点は料理か接客か)
- score:段階的なスコアを付ける(例:来店体験への満足度)
- noul:Yes/No的な二値判定(例:再来店の意向を示しているか)
「型付き」というのは、この各questionのtypeに応じて、レスポンスの形が厳密に決まっているという意味です。
choiceなら指定した選択肢のいずれか、scoreなら指定したスケール上の数値、noulなら0〜1の確率値、というように、typeごとに決まった形式でしか返ってきません。
さらにchoice/scoreの各回答には、選ばれた値だけでなく選択肢(またはスケール)ごとの確率分布と、エントロピーに基づく確信度(confidence)も付与されます(noulは0〜1の確率値のみで、確率分布・confidenceは付与されません)。
自由な文章を生成するのではなく、あらかじめ定義された型の中から「意思決定」を返すように設計されている、というのがJevの特徴です。
1-2. ふつうの推論サーバーでJevを再現できないのか
本家Jevの内部の仕組みは公開されていませんが、Jevのプロトコルをオープンに実装したOpenJevは、拡散(diffusion)モデルであるDiffusionGemmaに対して1ステップの特殊な「構造化読み取り(structured read)」を行い、モデルのlogits(softmax前の生スコア)から選択肢ごとの確率を直接読み取っています。
ただしこれには、diffusion_seed_canvasやdiffusion_read_onlyといった、vLLMにまだマージされていないリクエスト拡張が必要で、oMLXなど通常の推論サーバーのAPIでは利用できません。
つまり、少なくとも公開されている実装(OpenJev)の方式は、ふつうの推論サーバーでは再現できません。
余談ですが、私のキャッチアップが遅かったため、2026年9月24日時点で私自身はまだTypeSafe.aiの本家Jevアカウントを作成できていません(泣)
本家のJevも、アカウントを作成でき次第あらためて試してみたいと思います。
2. LocalJevは何ができる?
LocalJevは、OpenJevが必要とする特殊な推論サーバー機能を使わずに、手元の一般的な推論サーバーでもJev互換APIを動かせるようにするブリッジです。
TypeScript製で、Bunランタイム上で動作します。
2-1. 構成
LocalJevは、クライアントに公開するJev互換APIと、接続先であるアップストリームのバックエンドLLMをつなぐ変換レイヤーです。
- 公開するAPI:Jev互換のPOST /v1/systemoneエンドポイント(デフォルトhttp://127.0.0.1:8080)
- アップストリーム:OpenAI互換のChat Completions APIを実装した推論サーバー(デフォルトhttp://127.0.0.1:8000、モデルはdiffusiongemma-26B-A4B-it-4bit)
TypeSafe.aiの公式SDKからは、接続先URLとAPIキーを差し替えるだけで、TypeSafe.aiのAPIと同じように呼び出せます(モデル名のjev-latest/jev-previewもエイリアスとして受け付けます)。
2-2. 中身でやっていること
前段で説明した通り、OpenJevはモデルのlogitsを直接読み取って確率を得ますが、これには一般的な推論サーバーにはない拡張機能が必要です。
LocalJevはこれを迂回し、次のようなプロンプトベースの近似でJev互換の応答を組み立てます。
- stateと型付きのquestionsを、分類タスク用のプロンプトに変換する
- アップストリームのモデル(デフォルトはDiffusionGemma)に対して、確率のスカラー値・ベクトルをJSON形式で出力するよう指示する
- 返ってきたJSONを検証し、不正な形式であればリトライする
- 確率ベクトルを正規化し、Jev互換の「選択結果」「期待スコア」「エントロピーに基づく確信度」を計算する
- Jevと同じレスポンス形式に整形して返す
2-3. 重要な注意点(トレードオフ)
LocalJevはワイヤー互換(リクエスト・レスポンスの形式は同じ)ですが、数学的にはOpenJevのlogits読み取りと同等ではありません。
確率はモデルのlogitsから直接読み取ったものではなく、モデル自身に「自己申告」させたものです。
そのため、この確率の較正(calibration)が実用に耐えるかどうかは利用者側で検証する必要があり、LocalJevのREADMEも「重要な意思決定に使う前に自分のワークロードで検証すること」と明記しています。
この検証を支援するために、LocalJevにはAG News・BoolQ・SST-5などの公開データセットを使い、複数モデルの精度・較正・リトライ回数・レイテンシを比較する評価(bake-off)フレームワークも同梱されています。
3. 実際に動かしてみた
ここまでで説明したように、LocalJev単体はローカルの推論サーバー(oMLXなど)を前提にしています。
手元にMacの実機がない/GPUを積んだLinux機がないという場合、バックエンドだけAmazon Bedrockに向けられれば動くはずです。
3-1. gpt-ossならBedrockに直結できる
LocalJevが前提にしているアップストリームは、
Authorization: Bearer <APIキー>によるシンプルな認証POST /v1/chat/completions/GET /v1/modelsという、OpenAIと同じエンドポイント・レスポンス形式
の2点を満たすサーバーです。vLLMやllama.cpp、oMLXなど、いわゆる「OpenAI互換サーバー」はこれを満たします。
Bedrockが自前でホストしているOpenAI自身のオープンウェイトモデル(openai.gpt-oss-120bなど)は、POST /v1/chat/completions / GET /v1/modelsというエンドポイントもレスポンスのJSON構造もLocalJevが最初から前提にしているOpenAIのChat Completions形式そのもので返してくれます。
LocalJevが実際に読んでいるのはchoices[0].message.content(生成されたテキスト)とusage.prompt_tokens/usage.completion_tokens(トークン数)で(engine.tsの該当箇所)、gpt-oss側のレスポンスもこの形のまま返ってきます。
認証もAWSアクセスキーによるSigV4署名に加えて、シンプルなBearerトークン(Bedrock API key)でも受け付けてくれるので、LocalJevの実装(常にBearerトークンしか送らない)ともそのまま噛み合います (API compatibility、 Chat Completions API)。
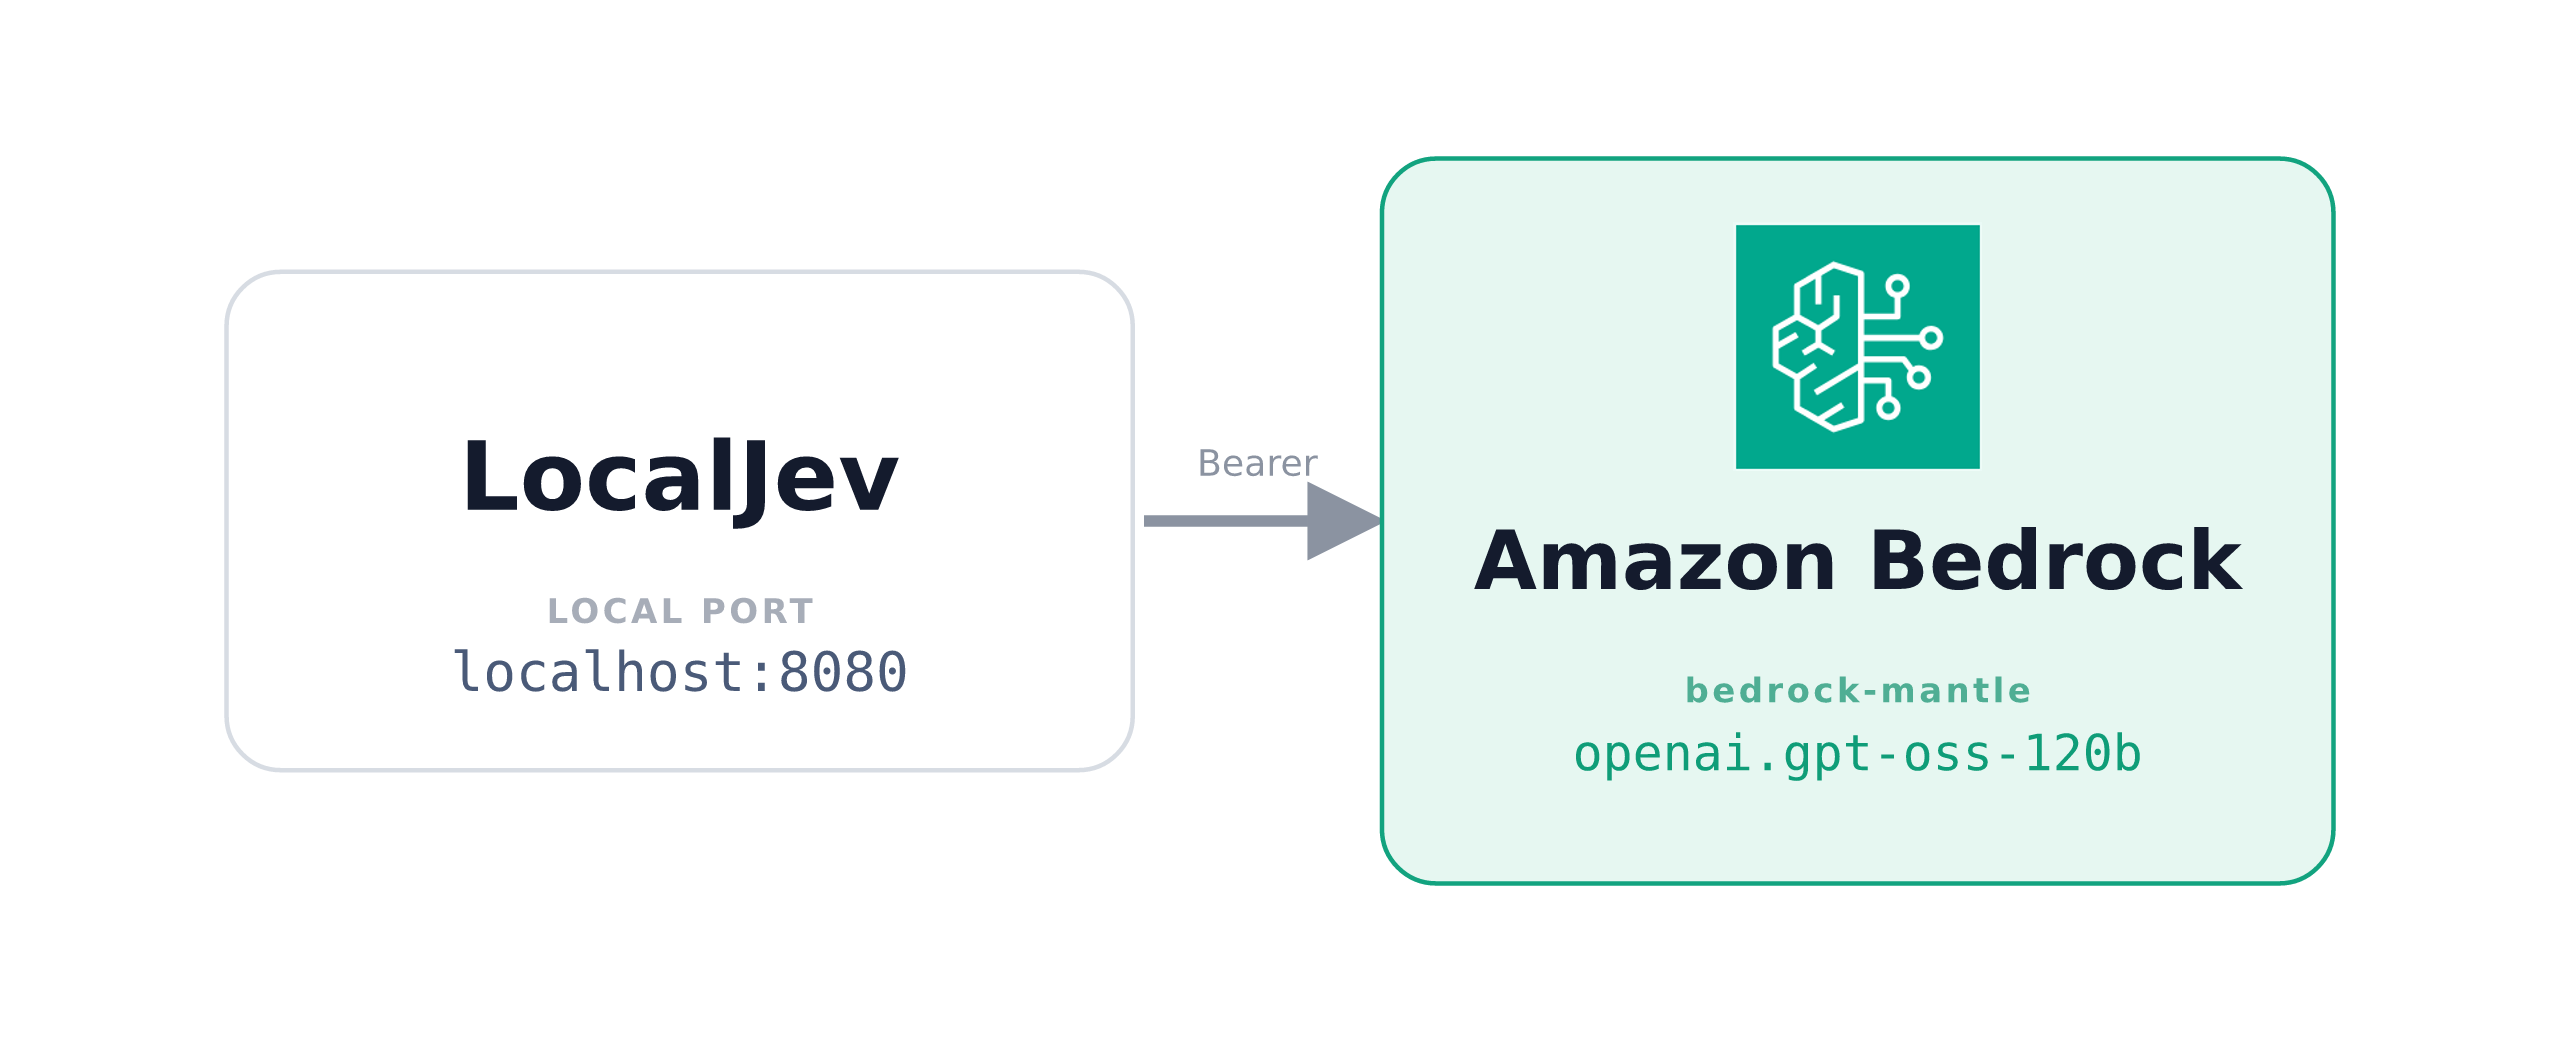
つまり、モデルにgpt-ossを選べば、LocalJevとBedrockの間で形式を変換する中継サーバーを用意しなくても、そのままつなげられるということです。そこで、今回はLocalJevからBedrockへ直結する構成で検証しました。
3-2. エンドポイントの選択:bedrock-runtimeかbedrock-mantleか
BedrockのOpenAI互換APIには2つのエンドポイントがあります(Chat Completions API)。
bedrock-runtime(AWS推奨):https://bedrock-runtime.{region}.amazonaws.com/openai/v1。ガードレール・構造化出力・ストリーミングに対応するが、GET /v1/modelsが未実装(実測でも404)bedrock-mantle(互換用):https://bedrock-mantle.{region}.api.aws/v1。Chat Completions/Responsesのみだが、GET /v1/modelsは実装済み
LocalJevの/readyヘルスチェックは、内部でGET {upstream}/v1/modelsを叩き、返ってきた一覧に接続先モデルのidが含まれているかで生死判定する実装になっています(engine.tsのready()メソッド)。
/readyが素直に機能するbedrock-mantleを選ぶ方が都合が良いと判断し、こちらを採用しました。
3-3. 一番の懸念:構造化出力のスキーマ制約は通るのか
直結する上で一つ気になっていたのが、この部分でした。
Bedrockの構造化出力機能は公式ドキュメント上、JSON Schema Draft 2020-12のサブセットしか受け付けず、minimum/maximum/minLength/maxLengthは非対応、minItemsも0/1のみ対応と明記されています。
LocalJevは確率をJSONで受け取るために、まさにこのminimum/maximum(確率0〜1の範囲制約)やminItems/maxItems(選択肢数と同じ長さの配列制約、多くの場合2以上)をresponse_format.json_schemaに付けて送ります。ドキュメント通りなら、直結した瞬間にここで拒否されるはずでした。
そこで、既存のAWSクレデンシャルを使い、LocalJevが実際に送るのと同じ形のスキーマをcurl --aws-sigv4で直接Bedrockに投げて確かめてみました。
curl "https://bedrock-mantle.ap-northeast-1.api.aws/v1/chat/completions" \
  --aws-sigv4 "aws:amz:ap-northeast-1:bedrock" \
  --user "$AWS_ACCESS_KEY_ID:$AWS_SECRET_ACCESS_KEY" \
  -H "X-Amz-Security-Token: $AWS_SESSION_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai.gpt-oss-120b",
    "messages": [
      {"role": "system", "content": "Return calibrated probabilities as instructed."},
      {"role": "user", "content": "<document>\"料理の提供まで30分かかりましたが、味も接客も申し分ありませんでした。また来たいと思います。\"</document>"}
    ],
    "temperature": 0,
    "max_tokens": 512,
    "seed": 1,
    "chat_template_kwargs": {"enable_thinking": false},
    "response_format": {
      "type": "json_schema",
      "json_schema": {
        "name": "localjev_evaluation",
        "strict": true,
        "schema": {
          "type": "object",
          "properties": {
            "answers": {
              "type": "object",
              "properties": {
                "q1": {"type": "array", "items": {"type": "number", "minimum": 0, "maximum": 1}, "minItems": 3, "maxItems": 3, "description": "probabilities"},
                "q2": {"type": "array", "items": {"type": "number", "minimum": 0, "maximum": 1}, "minItems": 3, "maxItems": 3, "description": "probabilities"},
                "q3": {"type": "number", "minimum": 0, "maximum": 1, "description": "probability yes/no"}
              },
              "required": ["q1", "q2", "q3"],
              "additionalProperties": false
            }
          },
          "required": ["answers"],
          "additionalProperties": false
        }
      }
    }
}'質問ラベル(q1/q2/q3)や内容はスキーマ形状(minimum/maximum/minItems/maxItems付きの配列と数値)を確かめるための仮のものですが、スキーマは拒否されず、次のレスポンスが返ってきました。
{
  "choices": [
    {
      "finish_reason": "stop",
      "index": 0,
      "message": {
        "role": "assistant",
        "content": "**Sent{ \"answers\": { \"q1\": [ 0.95, 0.03, 0.02 ], \"q2\": [ 0.98, 0.01, 0.01 ], \"q3\": 0.40 } }",
        "reasoning": "The user gave a document in Japanese: \"料理の提供まで30分かかりましたが、味も接客も申し分ありませんでした。また来たいと思います。\" This translates roughly: \"It took 30 minutes for the food to be served, but the taste and service were flawless. I would like to come again.\"\n\nThe user likely wants some analysis? The instruction: \"Return calibrated probabilities as instructed.\" The system says \"Return calibrated probabilities as instructed.\" But we have no explicit instruction about what probabilities to return. Possibly the user wants sentiment analysis with probabilities? The document is a review. So we might output probabilities for categories like positive, negative, neutral. Or maybe for aspects: taste, service, speed. The instruction is ambiguous.\n\nGiven typical tasks: sentiment classification with calibrated probabilities. So we can output something like: Positive: 0.95, Negative: 0.02, Neutral: 0.03. Also maybe aspect sentiment: taste positive 0.98, service positive 0.97, speed negative 0.4 (since 30 min is somewhat slow). Provide calibrated probabilities.\n\nThus respond with a JSON containing probabilities.",
        "refusal": null
      }
    }
  ],
  "created": 1790593167,
  "id": "chatcmpl-03ee5006-e729-4090-88e0-706c17021987",
  "model": "openai.gpt-oss-120b",
  "object": "chat.completion",
  "service_tier": "default",
  "usage": {
    "completion_tokens": 303,
    "prompt_tokens": 109,
    "total_tokens": 412
  }
}
HTTP 200。ドキュメントに書かれている制約はConverse/InvokeModelの構造化出力パスに対するものと考えられ、Chat Completions API経由のgpt-ossにはどうやら適用されないようでした(内部的にtool-callへのフォールバックなど別経路を通っている可能性がありますが、そこまでは確認できていません)。
LocalJevが付けて送るchat_template_kwargsもエラーにはなりませんでした(ただしreasoningが返ってきていることから、enable_thinking: falseの指定自体は無視されているようです)。message.contentの中身もスキーマ通り(q1/q2が長さ3の配列、q3が0〜1の数値)のJSONになっています。
ただし、よく見るとcontentの先頭に**Sentという余計な文字列が付いています。同じリクエストを何度か投げ直したところ、**のようなゴミが先頭に付く回と、JSONだけが返る回がありました。原因は不明ですが、LocalJevのJSON抽出処理は最初の{から波括弧の対応を数えてJSONを切り出す実装なので、この程度の前置きであれば問題なくパースできます。
もう一つ、この検証中に興味深い違いも見つかりました。bedrock-runtimeは推論過程を<reasoning>...</reasoning>タグとしてcontentフィールドの中に混ぜて返してくるのに対し、bedrock-mantleは推論過程を別のreasoningフィールドに分離し、contentにはほぼJSON本体だけを返してくれます。
LocalJevのJSON抽出処理は最初の{から切り出す実装なので、推論過程の中に{が含まれていると、そこから誤ってJSONとして切り出してしまうおそれがあります。contentにほぼJSONだけが入るbedrock-mantleの方が安全だと判断でき、/readyの件と合わせてこちらを採用する理由がもう一つ増えました。
3-4. 実際に叩いてみる
Authorization: Bearer <key>として使えるBedrock API keyを発行し、LocalJev側の.envを書き換えます。
LOCALJEV_UPSTREAM=https://bedrock-mantle.ap-northeast-1.api.aws
LOCALJEV_UPSTREAM_API_KEY=<生成したbedrock-api-key-...>
LOCALJEV_UPSTREAM_MODEL=openai.gpt-oss-120bLocalJevを起動し、まずは/readyを確認します。
curl http://127.0.0.1:8080/ready正常に起動しました。
{"status":"ready","upstream_model":"openai.gpt-oss-120b"}続いて、/v1/systemoneを叩いてみます。
curl -s http://127.0.0.1:8080/v1/systemone \
  -H 'Content-Type: application/json' \
  -d '{
    "state": "料理の提供まで30分かかりましたが、味も接客も申し分ありませんでした。また来たいと思います。",
    "model": "jev-latest",
    "questions": {
      "main_topic": {
        "type": "choice",
        "instructions": "口コミで最も重点的に語られている観点",
        "criteria": {
          "food": "料理の味・量・品質",
          "service": "接客・提供スピード",
          "atmosphere": "店内の雰囲気・清潔さ",
          "price": "価格・コストパフォーマンス"
        }
      },
      "satisfaction": {
        "type": "score",
        "instructions": "来店体験全体に対する満足度",
        "criteria": [
          "不満が大きく、良い点がほとんど無い",
          "良い点と不満な点が混在している",
          "全体的に満足しており、不満はほぼ無い"
        ]
      },
      "will_return": {
        "type": "noul",
        "instructions": "再来店の意向を示している"
      }
    }
  }'
問題なく動作し、次のレスポンスが返ってきました。
{
  "model": "localjev-0.2",
  "answers": {
    "main_topic": {
      "type": "choice",
      "choice": "food",
      "probabilities": {
        "food": 0.4,
        "service": 0.4,
        "atmosphere": 0.1,
        "price": 0.1
      },
      "confidence": 0.13903595255631895
    },
    "satisfaction": {
      "type": "score",
      "score": 1.8,
      "legend": {
        "0": "不満が大きく、良い点がほとんど無い",
        "1": "良い点と不満な点が混在している",
        "2": "全体的に満足しており、不満はほぼ無い"
      },
      "probabilities": {
        "0": 0,
        "1": 0.2,
        "2": 0.8
      },
      "confidence": 0.5445140849964047
    },
    "will_return": {
      "type": "noul",
      "noul": 0.99
    }
  },
  "usage": {
    "input_tokens": 433,
    "output_tokens": 513
  }
}main_topicはfoodとserviceがどちらも0.4で並びました。口コミが「味」と「接客」を同じ一文で並べて褒めており、さらに「提供まで30分」という接客・提供スピード寄りの話題も含んでいるため、無理にどちらかへ振り切らず迷いをそのまま確率で表現しています。confidenceが0.14と低いのもその表れです(確率が同点の場合は先に定義した選択肢が選ばれる実装のため、choiceはfoodになっています)。satisfactionは1.8(「全体的に満足しており、不満はほぼ無い」が0.8)で、30分待ちという不満点がありつつも「申し分ありませんでした」と締めくくっている内容をよく反映しています。will_returnは「また来たいと思います」という一文をしっかり拾い、noul値0.99でした。人が読んだときの印象に近い結果が返ってきています。
なお、リクエストでは"model": "jev-latest"を指定していますが、LocalJevはこれを自身のモデル(localjev-0.2)のエイリアスとして扱うため、レスポンスのmodelはlocaljev-0.2になっています。
LocalJevの.envを書き換えるだけで、Bedrock上のgpt-oss-120bへ直結する構成でJev互換APIが動くことを確認できました。
4. まとめ
Bedrockが自前でホストしているgpt-oss(OpenAI自身のオープンウェイトモデル)は、LocalJevが最初から前提にしているOpenAIのChat Completions形式(リクエスト・レスポンスとも)をBedrock上でもそのまま実装しているため、中継サーバーを用意せずに直結できることが確認できました。
今回はあくまで最小構成でのPoC(概念実証)であり、可用性やオートスケール、認証・監視まわりなど、本番運用を見据えた作り込みはまだ何もしていません。また、Bedrockのドキュメント上の構造化出力の制約が、gpt-oss経由のChat Completionsでは適用されない理由(内部的に何が起きているのか)や、長時間運用したときのスロットリング・コストの実態は未検証のままです。
社内で実際にこの構成へのニーズがあれば、これらを詰めた上でAWS上へのデプロイも検討したいと考えています。